Fuite de Claude 4.8 et arrivée de Gemini 3.5 dans l'Arena : la course à l'IA s'intensifie
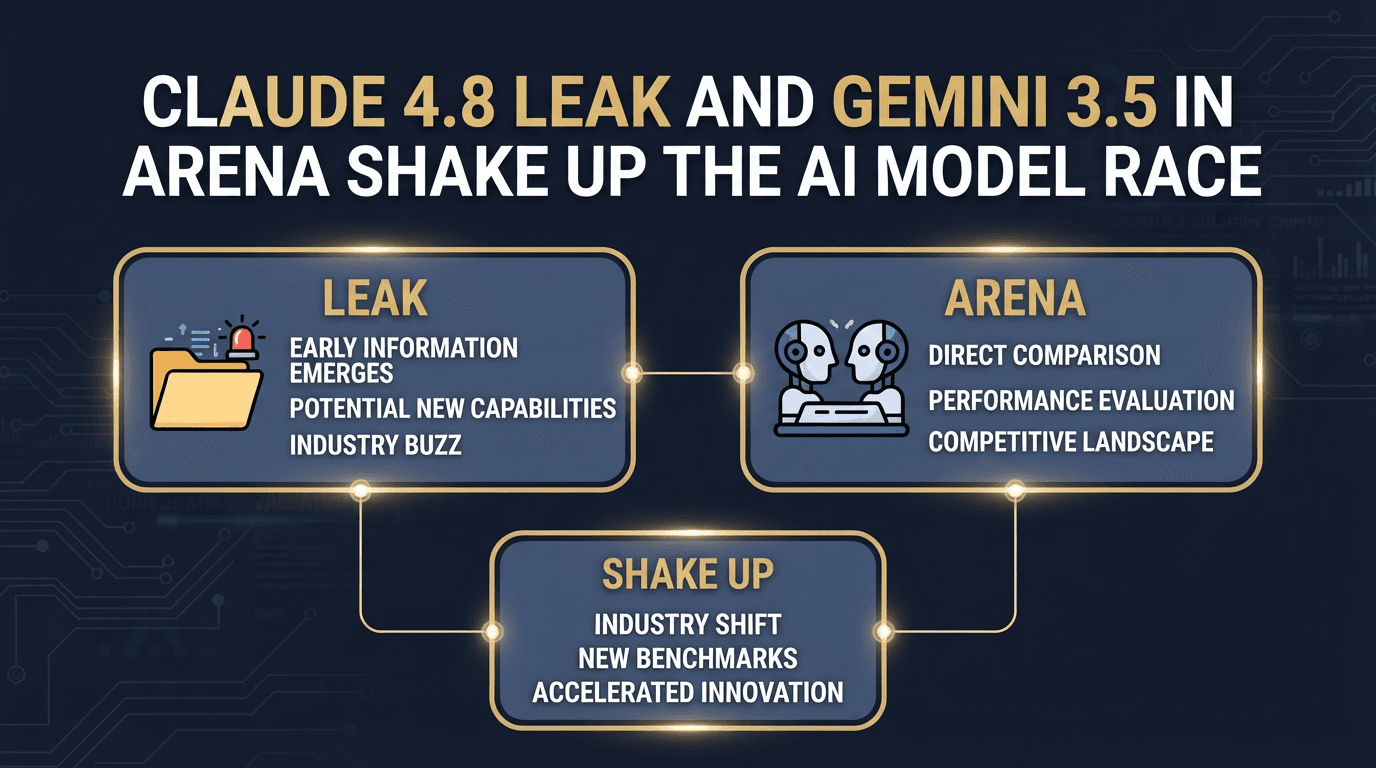
Une fuite majeure concernant le modèle Claude Sonnet 4.8 d’Anthropic, encore inédit, de nouvelles spéculations autour d’une future famille de modèles Claude « Cardinal », et l'arrivée discrète des variantes de Gemini 3.5 de Google dans le célèbre benchmark LMSYS Arena ont fait de cette semaine un moment charnière pour les observateurs, analystes et créateurs de contenu spécialisés dans l’IA, notamment ceux qui suivent les séries d’actualités comme celles de Jaylin Williams.
Claude Sonnet 4.8 : ce que la fuite révèle réellement
L'histoire de Claude Sonnet 4.8 commence par une erreur de packaging dans la bibliothèque npm @anthropic-ai/claude-code d’Anthropic. Des développeurs ont découvert qu'un fichier de source‑map de 59,8 Mo avait été publié par mégarde dans une mise à jour du 31 mars 2026, exposant environ 512 000 lignes de TypeScript interne et plus de 1 900 fichiers sources liés au produit Claude Code. Bien qu’aucune donnée client, identifiant ou système en production n’ait été compromis, le paquet de débogage contenait des références internes qui n'étaient pas destinées au public.
Parmi ces références figurait la chaîne de caractères « sonnet-4-8 », listée dans un filtre interne de « chaînes interdites » ou Undercover Mode, conçu pour empêcher les ingénieurs de mentionner accidentellement des versions de modèles non publiées dans les journaux, les textes d'interface ou les messages de validation (commit). La même liste incluait apparemment « opus-4-7 » ainsi que des noms de code tels que « mythos », laissant entrevoir une feuille de route plus large pour la famille phare Claude d’Anthropic.
Il est crucial de noter que ce qui a fuité est du code d'infrastructure et de configuration, et non un point de contrôle (checkpoint) ou des poids de modèle. Il n'existe aucune fiche technique publique, aucune documentation API pour un point de terminaison Sonnet 4.8, ni aucun tableau de benchmark. Le seul fait avéré par cette fuite est qu'Anthropic utilise une chaîne de version Sonnet 4.8 en interne dans ses outils, et que l'entreprise envisage ou teste au moins une nouvelle génération de sa gamme intermédiaire Sonnet.
Néanmoins, l'épisode a suscité d'intenses spéculations. Certaines publications circulant au sein de la communauté IA ont évoqué des améliorations telles qu'un gain à deux chiffres sur les benchmarks de programmation, des bonds significatifs dans la précision de la vision, et de nouvelles capacités d'« agent » en arrière-plan pour des tâches de longue haleine. Bien que ces affirmations semblent basées sur des références trouvées dans le code de débogage et sur des extrapolations à partir des récentes versions de Claude 4.x, aucune n’a été confirmée par Anthropic.
À la mi-août 2026, il n’y a toujours aucune version officielle de Claude Sonnet 4.8 via l’API Anthropic, Amazon Bedrock ou Vertex AI de Google Cloud. Anthropic a qualifié l’événement d'erreur humaine de packaging, a demandé la suppression des milliers de copies miroirs du paquet sur les dépôts publics, et ne s’est pas engagé publiquement à commercialiser un modèle sous le label Sonnet 4.8.
Noms de code des modèles d'Anthropic : Cardinal, Capybara et au-delà
La discussion autour de Sonnet 4.8 a attiré l'attention sur le réseau grandissant de noms de code internes utilisés par Anthropic pour ses modèles Claude. Des analyses antérieures du code source de Claude Code ont identifié des noms tels que Fennec (associé à un modèle de classe Opus 4.6), Capybara (lié à un palier expérimental qui se situerait au-dessus d'Opus en termes de capacités), et Numbat pour des modèles toujours en phase de test.
Dans ce contexte, les discussions communautaires autour d'une ligne provisoirement intitulée Claude « Cardinal » se sont intensifiées. Bien que les détails restent rares, les commentateurs décrivent Cardinal comme une potentielle nouvelle famille ou sous-catégorie qui pourrait se situer entre les offres actuelles Sonnet et Opus, ou comme une branche interne axée sur les outils, le codage et les agents persistants. À ce stade, Cardinal apparaît davantage comme un nom de code déduit et un indice de feuille de route qu’un produit commercial avec une fiche technique publique.
Le silence délibéré d’Anthropic renforce un schéma que l'entreprise a suivi lors des cycles précédents : les chaînes de version internes et les noms de code apparaissent souvent dans les outils et les fuites des mois avant toute annonce formelle. La présence de noms comme Sonnet 4.8 ou Cardinal dans le code ne garantit pas que ces modèles seront lancés sous ces étiquettes exactes, ni même qu'ils seront tous rendus publics.
Gemini 3.5 fait son entrée dans l'arène
Pendant qu’Anthropic gère les retombées de sa fuite de données, les derniers modèles de Google font sensation d'une toute autre manière : en apparaissant dans le Chatbot Arena de LMSYS, le benchmark participatif qui oppose les grands modèles de langage les uns aux autres dans des comparaisons à l'aveugle.
Ces dernières semaines, de nouvelles variantes étiquetées comme Gemini 3.5 sont apparues sur le classement de l'Arena. Bien que l'Arena utilise généralement des identifiants anonymisés pour les modèles lors des tests à l'aveugle, suffisamment de métadonnées et de tendances de performance ont émergé pour que les observateurs puissent attribuer plusieurs entrées performantes à la nouvelle génération Gemini de Google.
Les premières impressions de la communauté suggèrent que Gemini 3.5 maintient ou améliore les points forts de Gemini 1.5 en matière de contexte long et de multimodalité, tout en se concentrant sur un respect plus strict des instructions et une meilleure performance en codage. Dans de nombreux duels à l'aveugle, les utilisateurs rapportent que les modèles de classe 3.5 sont plus réactifs pour les conversations quotidiennes et les tâches de raisonnement, avec des résultats compétitifs face aux meilleurs systèmes d'Anthropic et d'OpenAI.
Comme le Chatbot Arena repose sur des votes volontaires, ses classements n'ont pas le même poids que les benchmarks académiques formels. Cependant, ce classement est devenu un indicateur réel important de la manière dont les modèles se comportent « dans la nature », capturant des facteurs qualitatifs tels que le style, la clarté et la robustesse, qui sont plus difficiles à résumer par un score numérique unique.
Comment les créateurs couvrent ces évolutions
La séquence rapide de développements — fuites, noms de code et nouvelles entrées aux benchmarks — a fourni aux créateurs axés sur l'IA une matière abondante. Parmi eux, Jaylin Williams, dont le contenu sur l'actualité de l'IA (incluant l'épisode mentionné dans la liste Mshale) agrège des sujets comme la fuite de Claude Sonnet 4.8, la rumeur de la ligne Claude Cardinal et l'arrivée de Gemini 3.5 dans l'Arena, afin d'en faire des mises à jour digestes pour les développeurs et les passionnés.
Dans ces synthèses, les créateurs mettent généralement en avant trois thèmes :
- L'intensification de la concurrence entre les modèles de pointe, alors qu'Anthropic, Google et OpenAI avancent à un rythme effréné, utilisant à la fois des lancements officiels et des évaluations discrètes dans des benchmarks publics pour tester leurs capacités.
- L'opacité et les fuites comme problèmes récurrents, les outils internes et les artéfacts de débogage devenant des fenêtres inattendues sur les feuilles de route des entreprises bien avant toute communication formelle.
- L'impact pratique sur les utilisateurs, des développeurs se demandant quand ils pourront réellement accéder aux performances de la classe Sonnet 4.8, aux entreprises évaluant s'il est préférable de bâtir leurs solutions autour de Claude, Gemini ou d'un mélange de fournisseurs.
Ce qu'il faut surveiller ensuite
À l'avenir, les questions clés pour les utilisateurs et les observateurs sont simples. Anthropic va-t-il annoncer officiellement un modèle Sonnet 4.8 ou Cardinal dans les mois à venir, et si oui, comment se positionnera-t-il par rapport à Opus et aux systèmes concurrents de Google et OpenAI ? Les capacités suggérées dans le code interne — allant de meilleures performances en codage et vision à des agents plus persistants — se traduiront-elles par des fonctionnalités accessibles et prêtes pour la production ?
Du côté de Google, tous les regards sont tournés vers la rapidité avec laquelle la gamme Gemini 3.5 passera des expériences dans l'Arena et des déploiements limités à une disponibilité étendue sur Google Cloud et les produits grand public. Tout changement dans la tarification, la longueur du contexte ou les options de réglage fin pourrait remodeler la manière dont les startups et les entreprises choisissent leurs fournisseurs.
Pour l'heure, le paysage est marqué par le contraste : la fuite involontaire d'Anthropic offre un aperçu de la direction que pourrait prendre Claude, tandis que Gemini 3.5 de Google cherche une validation dans la compétition ouverte. Ensemble, ils signalent un écosystème d'IA où les feuilles de route des produits sont de plus en plus visibles — non seulement par le biais de communiqués de presse, mais aussi par le code, les noms de code et le jugement collectif des utilisateurs mettant ces systèmes à l'épreuve.