allnewscast
Breaking News
AI & Tech

Des documents déclassifiés révèlent que Microsoft avait prévenu qu'une actualité générée par l'IA pourrait entraîner un cercle vicieux pour le journalisme
Nic Reeve11 min de lecture
Des documents déclassifiés révèlent que Microsoft avait prévenu qu'une actualité générée par l'IA pourrait entraîner un cercle vicieux pour le journalisme

Le 17 septembre 2026, de nouveaux documents judiciaires ayant été levés dans le cadre du procès pour violation de droits d'auteur intenté par The New York Times contre OpenAI et Microsoft ont révélé que de hauts dirigeants de Microsoft avertissaient que leurs produits d'IA d'actualités risquaient de créer une « spirale infernale » (doom loop) qui drainerait le trafic et l'argent des organes de presse, tout en dégradant la qualité de l'information sur le web lui-même.

Que disent les documents Microsoft déclassifiés sur l'IA et le journalisme ?

Les documents Microsoft déclassifiés décrivent des avertissements internes selon lesquels les moteurs de réponses par IA, entraînés sur des articles de presse, pourraient à la fois saper les modèles économiques des éditeurs et affaiblir l'écosystème d'information en ligne dont ces mêmes systèmes d'IA dépendent.

Des passages clés des dossiers montrent que les propres chercheurs et responsables de produits de Microsoft étaient alarmés par la manière dont les systèmes d'IA générative utilisent et remplacent le journalisme :

  • Selon TechCrunch, une présentation interne rédigée par le directeur de la science appliquée chez Microsoft, Brent Hecht, en janvier 2024, décrivait l'impact du scraping (collecte de données) par l'IA à grande échelle et des moteurs de réponses comme une « spirale infernale » qui « nuirait à la performance de nos modèles et à l'ensemble du web en même temps. »
  • Le Washington Examiner rapporte que Hecht a écrit : « Notre stratégie de contenu IA a déclenché une "spirale infernale" qui nuira à la performance de nos modèles et à l'ensemble du web en même temps », qualifiant la situation de « hautement inhabituelle » car le produit final menace « les fondements économiques de ses fournisseurs essentiels. »
  • Law360 et MLex notent que des documents internes citent des employés de Microsoft et d'OpenAI reconnaissant que l'utilisation non autorisée de millions d'articles de presse pourrait amorcer une spirale infernale mettant en danger leur « chaîne d'approvisionnement en contenu. »
  • The Wrap cite des documents où un rapport de Microsoft avertit que l'approche de l'IA des entreprises a déclenché une spirale infernale qui endommagerait à la fois la performance des modèles et « l'ensemble du web. »

Ces déclarations apparaissent dans un mémorandum non caviardé déposé par les avocats de The New York Times dans son procès en cours pour violation de droits d'auteur contre OpenAI et Microsoft devant le tribunal fédéral de Manhattan. L'affaire est en cours devant les tribunaux depuis 2023.

Qui, au sein de Microsoft, a tiré la sonnette d'alarme sur le scraping par l'IA et le « vol » de travail ?

Les inquiétudes au sein de Microsoft ont été menées par Brent Hecht, le directeur de la science appliquée de l'entreprise, qui a averti à plusieurs reprises que le scraping de masse du journalisme pour l'entraînement de l'IA s'apparentait à un vol sans précédent de travail humain.

Les documents déclassifiés attribuent plusieurs commentaires internes frappants à Hecht :

  • TechCrunch rapporte que Hecht a décrit le scraping par l'IA à grande échelle du contenu en ligne comme « le plus grand vol de travail de l'histoire de l'humanité » lors de discussions internes documentées en janvier 2023 et janvier 2024.
  • Le New York Daily News note qu'un haut dirigeant de Microsoft estimait que les systèmes d'IA construits sur le travail d'autrui seraient perçus comme « un vol stupéfiant de proportions sans précédent » et potentiellement « le plus grand vol de travail de l'histoire de l'humanité », selon les documents judiciaires non caviardés.
  • BrandiconImage et The Wrap citent tous deux Hecht qualifiant la copie d'articles de presse de « vol stupéfiant de proportions sans précédent » et potentiellement du « plus grand vol de travail de l'histoire de l'humanité. »
  • TweakTown, résumant les dossiers, affirme que Hecht a soutenu que le fait de s'appuyer sur l'« usage loyal » (fair use) pour justifier le scraping massif d'articles de presse faisait une « véritable dérision » du concept juridique de fair use.

Ces avertissements témoignent d'une reconnaissance interne que les pipelines d'entraînement de l'IA construits sur le travail des éditeurs n'étaient pas seulement risqués sur le plan juridique. Ils étaient perçus par certains des ingénieurs et scientifiques responsables des systèmes comme étant éthiquement et économiquement corrosifs pour l'ensemble de l'écosystème de l'information.

Comment le moteur de réponses IA de Microsoft affecte-t-il le trafic des éditeurs de presse ?

Les dossiers affirment que les outils de réponse alimentés par l'IA de Microsoft réduisent considérablement le trafic de référence vers les organes de presse, faisant craindre que cet effet de substitution ne puisse éroder la base financière qui soutient le journalisme professionnel.

Plusieurs sources décrivent des mesures internes et des témoignages sur la manière dont les réponses de l'IA modifient le comportement des utilisateurs :

  • TechBeat rapporte que des documents non caviardés indiquent que Hecht a averti en janvier 2024 que le moteur de réponses Copilot de Microsoft réduisait les taux de clics vers les articles du New York Times jusqu'à 93 % par rapport aux résultats de recherche traditionnels de Bing.
  • Le résumé de TweakTown des mêmes dossiers note des estimations internes selon lesquelles les chatbots et les boîtes de réponses par IA pourraient réduire le trafic des éditeurs de 51 % à 94 %, selon le scénario et le type de requête.
  • The Wrap relate le témoignage du PDG de Microsoft, Satya Nadella, selon lequel les conversations avec les chatbots avaient déjà remplacé les visites sur les sites d'information en « vous donnant l'information directement sur le site, sur la plateforme d'IA, plutôt que de devoir vous rendre à la source sous-jacente. »

Ces chiffres, tous attribués à des évaluations internes et à des témoignages judiciaires en 2024 et 2025, suggèrent que les moteurs de réponses par IA ne se contentent pas de coexister avec les sites d'information. Ils peuvent remplacer la nécessité pour de nombreux utilisateurs de cliquer, affaiblissant ainsi les revenus publicitaires et les abonnements qui dépendent des visites directes.

Qu'est-ce que la « spirale infernale » décrite par les dirigeants de Microsoft ?

La « spirale infernale » décrite dans les dossiers judiciaires fait référence à un cycle d'auto-renforcement dans lequel les systèmes d'IA sapent la viabilité économique des organes de presse, entraînant une dégradation du contenu sur le web, ce qui nuit ensuite aux modèles d'IA qui dépendent de ce contenu.

Des documents internes cités dans plusieurs rapports décrivent la logique de cette boucle :

  • Ground News et EuropeSays expliquent que le mémo de Hecht avertissait que les produits d'IA générative avaient créé une spirale infernale qui « dévore le web et détruit les entreprises dont ces entreprises ont volé le contenu », en substituant les réponses de l'IA aux visites chez les éditeurs.
  • Le Washington Examiner cite un document de Microsoft affirmant : « Il est hautement inhabituel qu'un produit final menace les fondements économiques de ses fournisseurs essentiels, mais c'est la situation que nous avons créée pour notre activité de LLM par rapport à sa "chaîne d'approvisionnement en contenu". »
  • BrandiconImage note que les dossiers décrivent un scénario dans lequel la baisse du trafic vers les sites d'information affaiblit l'écosystème en ligne global et, en fin de compte, réduit la qualité de l'information disponible pour les systèmes d'IA.
  • La couverture de TweakTown résume la boucle ainsi : les moteurs de réponses par IA réduisent le trafic, diminuent les incitations financières pour les journalistes, réduisent l'offre de reportages de haute qualité, puis endommagent les modèles mêmes qui ont besoin de ces reportages pour l'entraînement.

L'idée centrale est simple. Moins d'argent pour le journalisme signifie moins de reporters et des informations moins fiables. Les modèles d'IA entraînés sur ce contenu dégradé seront moins performants, ce qui nuira aux utilisateurs et aux plateformes elles-mêmes.

Comment le procès du New York Times cadre-t-il ces aveux internes ?

The New York Times utilise les aveux internes de Microsoft et d'OpenAI pour soutenir que les entreprises ont sciemment construit des systèmes d'IA rentables sur du contenu d'actualité non autorisé, tout en reconnaissant que cette stratégie menaçait les éditeurs mêmes qui produisaient ce contenu.

La couverture récente des documents déclassifiés expose la narration juridique du Times :

  • Le résumé de l'actualité juridique de KuCoin indique que le mémorandum récemment déclassifié dans le procès The New York Times v. OpenAI était rédigé par les avocats du Times et « comprenait largement » des déclarations et des entretiens avec des dirigeants de la tech reconnaissant que les grands modèles de langage étaient « construits sur un contenu décrit par les dirigeants de Microsoft comme un vol d'une ampleur sans précédent. »
  • Ground News rapporte que les dossiers présentent les propres mots des dirigeants pour montrer que les grands modèles de langage sont des technologies « prédatrices », entraînées sur du « contenu volé » qui posent un « risque existentiel » pour les écrivains, les artistes et les entreprises de médias humains.
  • MLex décrit les nouveaux documents comme montrant une connaissance des « coûts de la copie par l'IA pour les entreprises de presse américaines », incluant la reconnaissance que l'utilisation non autorisée de millions d'articles pour entraîner des chatbots pourrait amorcer la spirale infernale et représenter le « plus grand vol de travail de l'histoire de l'humanité. »
  • Law360 note que les employés de Microsoft et d'OpenAI avaient reconnu en interne depuis des années que les outils entraînés sur des articles de presse remplaceraient probablement les éditeurs, menant au scénario de la spirale infernale.

En mettant en lumière ces déclarations internes, le Times vise à renforcer sa thèse selon laquelle OpenAI et Microsoft se sont sciemment appuyés sur un journalisme non autorisé tout en prévoyant les dommages causés aux éditeurs.

Quelles sont les préoccupations internes d'OpenAI concernant les éditeurs et la substitution ?

Les dossiers déclassifiés ne se concentrent pas uniquement sur Microsoft. Ils révèlent également des craintes internes chez OpenAI selon lesquelles les chatbots deviendraient des substituts directs aux éditeurs de presse, sapant la viabilité économique du reportage continu.

Plusieurs sources résument ces préoccupations :

  • Selon BrandiconImage, Nick Turley, qui dirigeait l'équipe développant ChatGPT, a averti dans un mémo interne en 2023 que l'IA représentait une « menace existentielle » pour les éditeurs.
  • The Wrap rapporte que Turley a écrit que les éditeurs faisaient face à une menace existentielle provenant de produits d'IA qui étaient déjà « largement substitutifs » et le deviendraient davantage à mesure que les systèmes s'amélioreraient.
  • Law360 affirme qu'OpenAI et Microsoft ont reconnu pendant des années que les outils d'IA entraînés sur des articles de presse remplaceraient probablement les éditeurs, contribuant à la spirale infernale décrite dans les dossiers.

Ces commentaires internes font écho aux inquiétudes de nombreux rédacteurs en chef et reporters : si les utilisateurs peuvent demander un résumé à un chatbot au lieu de visiter un site d'information, le financement à long terme du journalisme indépendant devient précaire.

Quelles sont les implications plus larges de cette spirale infernale pour l'avenir de l'information ?

La spirale infernale décrite par le personnel de Microsoft et d'OpenAI suggère que les stratégies actuelles d'IA générative pourraient déstabiliser le secteur de l'information, réduire la qualité de l'information en ligne et, en fin de compte, endommager les systèmes d'IA eux-mêmes, à moins que de nouveaux arrangements économiques et juridiques n'émergent.

À travers les rapports, plusieurs thèmes reviennent :

  • Les dirigeants conviennent en privé avec les avertissements des éditeurs que l'IA générative pose une « menace existentielle » pour les organisations de presse lorsqu'elle siphonne à la fois le contenu et l'audience sans payer pour l'un ou l'autre.
  • Les discussions internes chez Microsoft soulignent que les fondements économiques du journalisme font partie de la « chaîne d'approvisionnement en contenu » pour l'IA, ce qui signifie que nuire aux éditeurs nuit également aux produits d'IA sur le long terme.
  • Les dossiers mettent en évidence le décalage entre les gains à court terme — offrir des réponses instantanées que les utilisateurs adorent — et les risques à long terme, tels que la diminution du nombre de reporters enquêtant sur des sujets d'intérêt public en raison de l'effondrement des revenus.
  • Plusieurs analyses soutiennent que le concept de spirale infernale pourrait pousser les tribunaux et les régulateurs à envisager de nouveaux modèles, notamment des accords de licence, des redevances obligatoires ou des limites explicites sur le scraping et l'entraînement à partir de données provenant d'organes de presse professionnels.

Le litige immédiat porte sur le contenu du New York Times et les produits d'IA actuels. La question sous-jacente est de savoir si le web sur lequel l'IA s'appuie peut survivre si son moteur économique central — le journalisme commercial et soutenu par les abonnements — est vidé par les systèmes mêmes qui scannent et résument désormais son travail.
Sources

  1. 1.techcrunch.com
  2. 2.nydailynews.com
  3. 3.washingtonexaminer.com
  4. 4.newsbytesapp.com
  5. 5.nypost.com
  6. 6.europesays.com
  7. 7.brandiconimage.com
  8. 8.ground.news
  9. 9.us.headtopics.com
  10. 10.kucoin.com
  11. 11.thewrap.com
  12. 12.law360.com
  13. 13.mlex.com
  14. 14.tweaktown.com
  15. 15.techbeat.co

Lire la suite →

Articles connexes

L'éventuelle introduction en bourse d'Anthropic met à l'épreuve les valorisations de l'IA et l'appétit des investisseurs
AI & Tech

L'éventuelle introduction en bourse d'Anthropic met à l'épreuve les valorisations de l'IA et l'appétit des investisseurs

Anthropic prépare une éventuelle introduction en bourse en novembre qui pourrait lever plus de 100 milliards de dollars et valoriser le développeur de Claude jusqu'à 2 billions de dollars, testant ainsi l'appétit des investisseurs pour un marché de l'intelligence artificielle fondé sur une croissance et des coûts extraordinaires. L'entreprise n'a pas encore confirmé le calendrier ni la valorisation. Reuters a rapporté le 22 octobre qu'Anthropic pourrait commercialiser des actions durant la semaine du 9 novembre à une valorisation que certains investisseurs situent près de 1,5 billion de dollars. Anthropic a indiqué aux investisseurs que le chiffre d'affaires du troisième trimestre a atteint 16,8 milliards de dollars, en hausse de 45 % par rapport aux 11,6 milliards de dollars du deuxième trimestre, selon le New York Times. Un projet de prospectus a révélé une perte nette de 80,7 milliards de dollars pour le premier semestre 2026, a rapporté Fortune le 21 octobre. Pourquoi Anthropic envisage-t-elle une cotation en bourse maintenant ? Anthropic se tourne vers les marchés boursiers alors que la demande pour Claude et d'autres outils d'IA d'entreprise s'accélère. La société a soumis confidentiellement un projet de déclaration d'enregistrement le 1er juin, selon la compilation de Sacra sur les annonces d'introduction en bourse et de financement. Un dépôt public exposerait ses états financiers, ses contrats, ses risques et sa structure de propriété à un public beaucoup plus large. Le calendrier reste incertain. IFR a rapporté le 15 octobre qu'Anthropic prévoyait de déposer son dossier publiquement le 26 octobre, de commencer sa tournée de présentation auprès des investisseurs le 9 novembre et de fixer le prix de l'offre la semaine suivante. Reuters a rapporté plus tard que ces dates pourraient changer, tandis que l'Associated Press affirmait que l'offre pourrait arriver dès le mois prochain. Fenêtre de cotation potentielle : novembre, selon les rapports de Reuters, IFR et AP. Objectif de levée de fonds potentiel : plus de 100 milliards de dollars, selon le New York Times. Banques d'affaires chefs de file rapportées : Goldman Sachs et Morgan Stanley, selon les informations résumées par Yahoo Finance. Une introduction en bourse donnerait à Anthropic l'accès aux capitaux publics pour le calcul, la recherche et l'expansion. Cela imposerait également un examen trimestriel à une entreprise dont les besoins de dépenses peuvent augmenter aussi rapidement que ses ventes. Quelle pourrait être l'ampleur de l'offre ? La transaction proposée pourrait figurer parmi les plus grandes introductions en bourse de l'histoire. Le New York Times a rapporté que les banquiers ont discuté d'une levée de plus de 100 milliards de dollars sur la base d'une valorisation d'environ 2 billions de dollars. Reuters a cité un chiffre inférieur discuté par certains investisseurs, autour de 1,5 billion de dollars, montrant à quel point le prix final peut dépendre des conditions du marché et de la demande. La valorisation d'Anthropic sur le marché privé a déjà grimpé rapidement. Sacra a rapporté qu'un financement de série H en mai a valorisé la société à 965 milliards de dollars. La même source a indiqué qu'un tour de série G en février a valorisé Anthropic à 380 milliards de dollars. Ces chiffres ne sont pas interchangeables avec une capitalisation boursière publique. Les investisseurs publics peuvent réévaluer le prix des actions immédiatement, et les valorisations lors des introductions en bourse fluctuent souvent pendant la phase de commercialisation. Valorisation privée de mai 2026 : 965 milliards de dollars, rapportée par Sacra. Valorisation potentielle de l'IPO : jusqu'à 2 billions de dollars, rapportée par IFR et le New York Times. Discussions d'investisseurs plus basses : environ 1,5 billion de dollars, rapportées par Reuters. Fortune a rapporté qu'un investisseur de longue date s'attendait à un prix proche de 1,8 billion de dollars et pensait que les actions pourraient être échangées plus tard à 2,4 billions de dollars. Cette vue est une prévision individuelle, et non un objectif de l'entreprise ou une transaction réalisée. Les ventes d'Anthropic croissent-elles assez vite ? La croissance rapportée du chiffre d'affaires est le principal argument en faveur de l'offre. Anthropic a déclaré aux investisseurs que le chiffre d'affaires du troisième trimestre a atteint 16,8 milliards de dollars, contre 11,6 milliards de dollars au deuxième trimestre, selon le New York Times et IFR. Ces chiffres décrivent une forte augmentation séquentielle des ventes provenant des abonnements Claude, des accords d'entreprise et des services connexes. Les résultats précédents montrent l'ampleur de l'accélération. Sacra a rapporté 16,3 milliards de dollars de revenus comptabilisés pour le premier semestre 2026, contre 1,1 milliard de dollars un an plus tôt. IFR a rapporté que le revenu récurrent annualisé s'élevait à un montant estimé à 74 milliards de dollars à la fin du troisième trimestre, citant l'analyste technologique de DA Davidson, Gil Luria. Chiffre d'affaires du premier semestre 2026 : 16,3 milliards de dollars, contre 1,1 milliard de dollars un an plus tôt, rapporté par Sacra. Chiffre d'affaires du deuxième trimestre 2026 : 11,6 milliards de dollars, rapporté par le New York Times. Chiffre d'affaires du troisième trimestre 2026 : 16,8 milliards de dollars, rapporté par le New York Times et IFR. Les chiffres ne sont pas parfaitement comparables. Le revenu comptabilisé, les ventes trimestrielles et le revenu récurrent annualisé utilisent des mesures différentes. Les analystes examineront la concentration de la clientèle, la durée des contrats, les revenus différés et la part des ventes liée à un petit nombre de grandes entreprises technologiques. Pourquoi les pertes pourraient-elles inquiéter les investisseurs du marché public ? La croissance rapide des ventes n'a pas éliminé le risque financier central : construire et exploiter des systèmes d'IA de pointe coûte cher. Fortune a rapporté que le projet de prospectus d'Anthropic révélait une perte nette de 80,7 milliards de dollars pour les six premiers mois de 2026. Ce chiffre obligera les investisseurs à évaluer si les revenus actuels pourront éventuellement couvrir les coûts de calcul, de centres de données, de personnel et de développement de modèles. La rentabilité rapportée dépend également de la méthode comptable utilisée. Yahoo Finance, citant des rapports sur les chiffres du troisième trimestre de la société, a indiqué qu'Anthropic avait affiché un profit ajusté. Un résultat ajusté peut exclure des dépenses qui restent économiquement pertinentes ; les investisseurs se concentreront donc sur le bénéfice net audité, le flux de trésorerie opérationnel et les engagements de capital une fois que le prospectus sera public. Perte nette rapportée pour le premier semestre 2026 : 80,7 milliards de dollars, selon Fortune. Chiffre d'affaires du troisième trimestre : 16,8 milliards de dollars, selon le New York Times. Facilité de crédit potentielle : environ 15 milliards de dollars, rapportée par The Daily Star. La facilité de crédit renouvelable proposée fournirait une liquidité supplémentaire, mais l'emprunt ajouterait des obligations en plus du financement par fonds propres. Les investisseurs voudront également des détails sur la question de savoir si les fournisseurs de cloud, les fournisseurs de puces ou les partenaires stratégiques bénéficient de conditions commerciales spéciales. Qu'examineront les investisseurs dans le prospectus ? Le prospectus déterminera si la croissance affichée se traduit par un modèle viable pour une société cotée. Il devra montrer comment Anthropic gagne de l'argent, ce que les clients paient, combien elle dépense pour servir chaque modèle et quels accords soutiennent la demande future. Il identifiera également les risques juridiques, réglementaires et concurrentiels que les investisseurs privés ont pu évaluer à huis clos. Concentration de la clientèle : la proportion de revenus liée aux plus gros clients. Exposition aux infrastructures : engagements envers la capacité cloud, les puces et les centres de données. Économie des modèles : coûts d'inférence, changements de prix et marges brutes par produit. Gouvernance : le rôle de la structure à bénéfice public d'Anthropic et de sa mission à long terme. Concurrence : pression exercée par OpenAI, Google, Meta et d'autres développeurs de modèles. La structure à bénéfice public de l'entreprise pourrait recevoir une attention inhabituelle. AP a rapporté qu'Anthropic élabore des plans pour partager la richesse future dans le cadre de ses préparatifs plus larges pour une introduction en bourse. Le mécanisme exact et sa force exécutoire compteront pour les actionnaires, les employés et les décideurs politiques. Que pourrait signifier les débuts d'Anthropic pour le marché de l'IA au sens large ? La cotation d'Anthropic deviendrait un test concret pour savoir si les investisseurs publics acceptent des valorisations fondées sur la demande future en IA plutôt que sur des bénéfices établis. Des débuts réussis pourraient encourager d'autres entreprises privées d'IA à chercher une cotation et offrir une voie de sortie plus claire aux investisseurs en capital-risque. Des débuts décevants pourraient peser sur les valorisations de tout le secteur. Le timing rend le test encore plus aiguisé. Reuters a rapporté que d'autres entreprises d'IA ont été mises sur la touche par l'inquiétude des marchés, tandis qu'Anthropic continue de préparer son offre. L'entreprise entrerait donc sur le marché avec peu de marge d'erreur. Ses banquiers doivent équilibrer une transaction de taille record face au risque de demander aux investisseurs publics d'absorber trop d'actions d'un coup. Anthropic n'a toujours pas de prix final, de nombre d'actions ou de date de dépôt public confirmés. Le prochain événement décisif sera le prospectus. D'ici là, le marché juge une possible introduction en bourse à travers des chiffres rapportés qui mélangent revenus trimestriels, estimations de ventes annualisées, valorisations privées et projets de publications financières.

Nic Reeve·
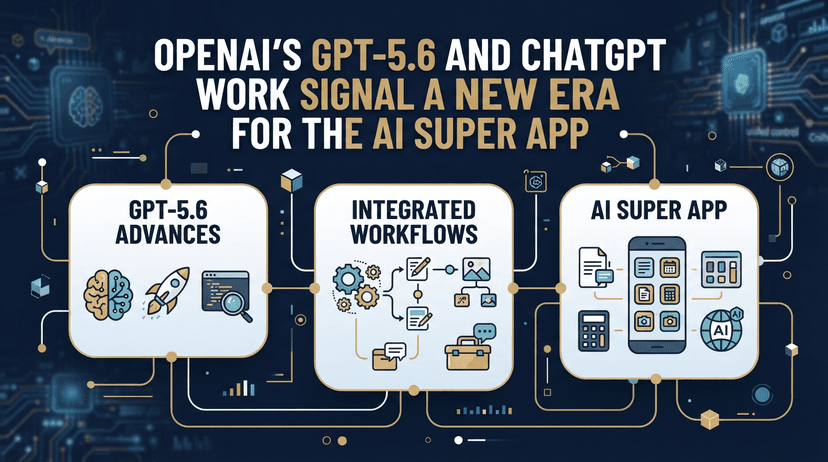
GPT-5.6 et ChatGPT : OpenAI ouvre l'ère de la « super-app » d'IA
AI & Tech

GPT-5.6 et ChatGPT : OpenAI ouvre l'ère de la « super-app » d'IA

OpenAI a lancé GPT-5.6 ainsi qu'une expérience de bureau repensée et unifiée appelée ChatGPT Work , marquant l'un des changements les plus significatifs vers une « super application d'IA » capable de planifier, créer et exécuter des tâches numériques complexes à travers divers outils et appareils. Parallèlement, ce lancement résonne dans l'ensemble de l'écosystème technologique et de la productivité, incitant les développeurs, les entreprises et les utilisateurs quotidiens à repenser leur manière de structurer le travail autour d'agents d'IA de plus en plus autonomes. GPT-5.6 : Une nouvelle famille de modèles de pointe GPT-5.6 est la toute dernière famille de modèles de pointe d'OpenAI, désormais disponible via ChatGPT, Codex, la nouvelle application ChatGPT Work et l'API OpenAI. Cette sortie fait passer le modèle d'une phase de prévisualisation limitée à une disponibilité générale, ouvrant l'accès aux développeurs et aux entreprises du monde entier. OpenAI et les premiers testeurs décrivent GPT-5.6 comme étant nettement plus performant en matière de raisonnement multi-étapes, de tâches de codage complexes et de projets à long terme par rapport à ses prédécesseurs. La famille de modèles est organisée en trois variantes principales : Sol – le modèle phare, doté des capacités les plus élevées pour les tâches de raisonnement et de création les plus exigeantes. Terra – une option équilibrée et rentable destinée aux charges de travail quotidiennes. Luna – un niveau plus abordable optimisé pour l'échelle, permettant des cas d'utilisation à haut volume. Les premières revues techniques notent que Sol, présenté fin juin et entièrement déployé en juillet, affiche des gains notables dans la création d'applications de bout en bout, y compris les applications web et les outils métier internes, avec moins d'itérations et une meilleure conformité aux spécifications. Les testeurs rapportent que le modèle peut désormais gérer des structures de projet complètes, de la planification des schémas de données et des API à la génération de composants front-end, tout en maintenant une cohérence entre les fichiers. ChatGPT Work : La nouvelle super application pour la productivité En complément de GPT-5.6, OpenAI a introduit ChatGPT Work , une « super application » de bureau unifiée destinée à servir de point d'entrée unique pour la productivité des cadres et employés de bureau. Loin d'être une simple interface de chat, ChatGPT Work agit comme un agent d'IA capable d'opérer en continu sur des tâches, orchestrant des flux de travail entre les fichiers locaux, le stockage cloud, les outils de communication et les navigateurs. L'application fusionne des expériences auparavant distinctes — le ChatGPT standard, l'assistant de codage Codex et l'expérience de navigation Atlas — au sein d'une interface repensée pour le bureau, le web et le mobile. Dans cet environnement, ChatGPT Work peut : Se connecter à des outils de travail tels que les e-mails, les calendriers, les plateformes de messagerie, les lecteurs cloud et les CRM via des plugins ou des intégrations natives. Rassembler du contexte à partir de ces sources pour comprendre les projets en cours, les échéances et les documents disponibles. Générer des livrables allant des documents et feuilles de calcul aux présentations, sites web et outils internes. Exécuter des flux de travail de longue durée en arrière-plan, en décomposant les grands objectifs en plans multi-étapes et en informant l'utilisateur au fur et à mesure que les étapes sont franchies. OpenAI positionne ChatGPT Work comme un agent à la fois local et cloud. Sur le bureau, l'application peut lire et organiser des fichiers locaux, modifier des documents et interagir avec d'autres logiciels installés. Dans le cloud, elle peut coordonner des actions entre les services connectés, permettant de concevoir des flux de travail qui couvrent plusieurs équipes et systèmes. Mise au repos d'Atlas et consolidation de l'écosystème La poussée vers une super application a également conduit OpenAI à simplifier sa gamme de produits. L'entreprise a confirmé que ChatGPT Atlas , son navigateur IA de bureau autonome lancé en 2025, est retiré. Les fonctionnalités de navigation web agentique du navigateur et les leçons tirées des données utilisateurs sont intégrées dans l'application de bureau unifiée ChatGPT, incluant une nouvelle expérience de navigation intégrée et des fonctionnalités telles qu'une barre latérale Chrome. En consolidant Chat, Work et Codex en une seule expérience de bureau, OpenAI vise à réduire la fragmentation et à offrir aux utilisateurs un hub cohérent pour l'IA conversationnelle, l'assistance au codage et l'exécution de tâches par agents. Les observateurs de l'industrie y voient une tendance plus large, les entreprises d'IA cherchant à devenir l'interface principale du travail numérique plutôt qu'un simple outil parmi d'autres. Stratégie d'accès et de déploiement Le déploiement de GPT-5.6 et de ChatGPT Work est échelonné selon les niveaux d'abonnement d'OpenAI. L'application de bureau unifiée pour Mac et Windows est disponible immédiatement, y compris pour les utilisateurs gratuits, qui accèdent généralement à une variante de modèle optimisée pour le quotidien. Les niveaux supérieurs tels que Pro, Entreprise et Éducation bénéficient d'un accès prioritaire aux capacités complètes de GPT-5.6 — notamment les variantes Sol et Terra — ainsi qu'aux fonctionnalités avancées de ChatGPT Work. Les clients Plus et Business sont intégrés progressivement sur plusieurs jours, avec des fonctionnalités comme la collaboration multi-agents, l'appel d'outils par programmation via l'API Responses, et des « Sites » hébergés pour la publication rapide de contenu web, mis en avant comme des différenciateurs pour un usage professionnel. L'entreprise présente cela comme une évolution, passant de sessions de chat isolées à une collaboration IA persistante au niveau du projet. Implications concurrentielles et sur le marché Le calendrier et l'ampleur du lancement ont des implications concurrentielles claires. ChatGPT Work, propulsé par GPT-5.6, est explicitement positionné contre les offres axées sur l'espace de travail des entreprises d'IA rivales, y compris les outils agentiques qui aident les équipes à gérer des documents, des bases de connaissances et des tâches de projet. Les analystes notent qu'en regroupant les fonctionnalités de codage, de navigation et de productivité dans une seule application, OpenAI tente d'ancrer les flux de travail des utilisateurs dans son écosystème en prévision d'une éventuelle introduction en bourse. Certains commentateurs ont comparé cette décision aux changements de plateforme précédents, tels que l'essor des suites bureautiques intégrées et des systèmes d'exploitation pour smartphones qui ont combiné communication, productivité et médias dans un seul environnement. Si elle réussit, la stratégie de super application pourrait faire en sorte que les agents d'IA ne soient plus perçus comme des services séparés, mais comme la couche d'exploitation par défaut du travail intellectuel. Réception initiale des développeurs et utilisateurs avancés Les premiers retours des développeurs se sont concentrés sur les performances de GPT-5.6 Sol dans des scénarios de codage réels. Les premiers utilisateurs rapportent avoir construit plusieurs applications fonctionnelles — telles que des tableaux de bord internes, des portails clients et des scripts d'automatisation — en quelques jours, le modèle gérant davantage le travail de liaison entre les services et les frameworks que les générations précédentes. Les utilisateurs avancés dans les rôles de productivité et d'opérations soulignent la promesse de l'interface de type « tour de contrôle » de ChatGPT Work, qui leur permet de définir des objectifs et de suivre la progression au fur et à mesure que l'agent accomplit les tâches, plutôt que d'émettre constamment des requêtes ponctuelles. Néanmoins, des questions subsistent concernant la gouvernance, l'auditabilité et la profondeur d'intégration dans des environnements d'entreprise complexes, où les problèmes de conformité et de résidence des données peuvent ralentir l'adoption. Des fils d'actualité IA aux flux de travail quotidiens L'évolution rapide des modèles de classe GPT-4 vers GPT-5.6 et une super application entièrement fusionnée souligne à quelle vitesse l'IA passe de la nouveauté à l'infrastructure. Dans les résumés hebdomadaires de l'actualité de l'IA, les commentateurs soulignent que l'essentiel n'est plus seulement les benchmarks bruts des modèles, mais la manière dont ces systèmes sont intégrés dans des outils qui remodèlent les routines quotidiennes — du développement logiciel et de l'analyse financière au marketing, à la recherche et à la coordination administrative. Le dernier lancement d'OpenAI suggère que la prochaine phase de compétition se concentrera sur qui pourra fournir l'espace de travail agentique le plus puissant, fiable et fluide. GPT-5.6 et ChatGPT Work sont conçus comme une réponse combinée à ce défi : une nouvelle famille de modèles associée à un environnement d'exploitation où l'IA peut non seulement répondre aux questions, mais aussi mener à bien des projets à travers le paysage numérique dans lequel le travail moderne se déroule.

Nic Reeve·
Les chercheurs en IA s'orientent vers l'inférence vérifiable et le raisonnement auditable des modèles
AI & Tech

Les chercheurs en IA s'orientent vers l'inférence vérifiable et le raisonnement auditable des modèles

Anthropic a déclaré le 2 novembre 2026 avoir fait progresser la vérification cryptographique pour l'inférence des grands modèles de langage, présentant un système capable de générer des preuves pour un modèle de type "mixture-of-experts" (mélange d'experts) de 400 milliards de paramètres. Ce travail vise à permettre aux utilisateurs de confirmer qu'une réponse provient bien du modèle convenu et qu'elle n'a pas été altérée pendant le calcul. Anthropic a rapporté environ 110 tokens par seconde sur un seul GPU H100 pour Llama 4 Maverick dans une configuration 4-bit. L'entreprise a précisé que chaque requête de 1 024 tokens produisait une preuve d'environ 19 mégaoctets. PRIME a rapporté zéro conclusion injustifiée sur 480 tâches basées sur des registres publics, contre 26,7 % pour un agent non structuré. Qu'a démontré Anthropic ? Anthropic a décrit FlashProve, un système construit autour des arguments de connaissance succincts non interactifs à divulgation nulle de connaissance, ou zkSNARKs. Cette approche permet à un fournisseur de s'engager sur le comportement du modèle tout en gardant les détails de celui-ci cachés au vérificateur. La mise à jour de recherche d'Anthropic du 2 novembre fait suite à un changement de terminologie le 19 octobre, date à laquelle Anthropic a commencé à utiliser « vérification d'inférence » au lieu d'« inférence prouvable ». Anthropic a précisé que le test utilisait Llama 4 Maverick, un modèle MoE de 400 milliards de paramètres, plutôt qu'un petit modèle de recherche. La configuration rapportée utilisait un seul GPU H100, des poids quantifiés en 4-bit et une arithmétique entière pendant le prefill. L'entreprise a mesuré la génération de preuves à environ 110 tokens par seconde, avec des fichiers de preuve proches de 19 Mo pour 1 024 tokens générés. Ces chiffres proviennent du rapport technique d'Anthropic et non d'un benchmark indépendant. Modèle : Llama 4 Maverick, décrit par Anthropic comme un modèle MoE de 400 milliards de paramètres. Matériel : un GPU Nvidia H100. Sortie de preuve : environ 19 Mo par requête de 1 024 tokens. La question pratique est celle du coût. Une preuve doit être générée, transmise et vérifiée en même temps que la réponse. Les chiffres d'Anthropic montrent que la tâche ne se limite plus à des systèmes de démonstration, mais ils n'établissent pas que la génération de preuves est suffisamment peu coûteuse pour chaque requête de consommateur ou pour un service à haut volume. Pourquoi les preuves cryptographiques sont-elles utiles pour les modèles de langage ? La sortie ordinaire d'un modèle fournit peu de preuves sur la manière dont une réponse a été produite. Un utilisateur peut connaître le nom du fournisseur, l'étiquette du modèle et la version du logiciel, tout en manquant d'un moyen fiable de vérifier que la réponse provient bien du modèle promis. Une preuve cryptographique pourrait lier la sortie à un calcul certifié. Anthropic a déclaré que les zkSNARKs sont adaptés à cette tâche car ils peuvent fournir une vérification sans révéler les poids privés du modèle. Cette séparation est cruciale pour les systèmes commerciaux. Un fournisseur pourrait protéger son modèle tout en permettant à un client, un auditeur ou un régulateur de tester si le calcul revendiqué a bien eu lieu. La vérification ne rend pas une réponse vraie. Une preuve peut établir qu'un modèle particulier a produit un flux de tokens spécifique sous des conditions déterminées. Elle ne peut pas, à elle seule, établir que la réponse factuelle du modèle est correcte, que ses données d'entraînement étaient fiables ou que la requête était inoffensive. Ces questions nécessitent des vérifications distinctes, telles que la récupération d'informations (retrieval), des solveurs formels ou une révision humaine. Cette distinction sépare l' intégrité de l'exécution de la qualité de la réponse . Cette distinction est au cœur des dernières recherches. Le travail cryptographique vise à savoir si le calcul promis a eu lieu. D'autres systèmes visent à savoir si le raisonnement soutient la conclusion. Comment les chercheurs vérifient-ils le raisonnement lui-même ? Plusieurs études d'octobre 2026 ont abordé la vérification au niveau de la sortie et du raisonnement plutôt qu'au niveau de la couche d'exécution cryptographique. PRIME, présenté dans un article soumis le 15 octobre, impose à un agent de s'engager sur des routes de preuves avant d'évaluer des registres publics. Un programme distinct enregistre les vérifications et bloque les conclusions que ces vérifications ne justifient pas. Les auteurs de PRIME ont testé 480 tâches basées sur des registres publics. Ils ont rapporté qu'un agent conventionnel produisait une conclusion injustifiée sur 26,7 % des tâches, tandis que PRIME n'en a produit aucune. Le système a également augmenté le score moyen des conclusions justifiées, passant de 30,1 (avec le simple refus) à 59,2 après l'ajout de directives et de vérifications. PRIME : s'engage sur des règles et des routes de preuves avant de tirer des conclusions. Jeu de test : 480 tâches basées sur des registres publics. Taux d'erreur rapporté : 26,7 % pour l'agent de comparaison et zéro pour PRIME. VERGE a suivi une voie différente. L'article publié en octobre dans les EMNLP Findings décompose les réponses en affirmations atomiques, traduit ces affirmations en logique du premier ordre et les envoie à des prouveurs de théorèmes automatisés ou à d'autres contrôles. Les auteurs ont rapporté une amélioration moyenne de performance de 18,7 % lors de la convergence avec GPT-OSS-120B, par rapport aux réponses en un seul passage sur leurs benchmarks de raisonnement. Ces systèmes restreignent le champ de l'affirmation. Ils ne prouvent pas chaque partie d'une réponse ouverte. Ils vérifient des propositions sélectionnées selon des règles explicites. Quel rôle joue l'auto-vérification ? RISE, publié dans les actes de NeurIPS 2026 le 8 octobre, entraîne un modèle à résoudre des problèmes et à évaluer ses propres solutions dans le même processus d'apprentissage par renforcement. La méthode utilise des récompenses vérifiables provenant d'un vérificateur de résultats, appliquant le feedback à la fois à la génération de la solution et à l'auto-vérification. Les chercheurs ont rapporté des gains sur les benchmarks de raisonnement mathématique et un comportement d'auto-vérification plus fréquent et plus précis. La conception répond à une faiblesse connue : un modèle peut produire une critique confiante sans détecter l'erreur centrale de sa propre réponse. L'auto-vérification reste moins robuste qu'une preuve externe lorsque le vérificateur partage les angles morts du modèle. Une réponse mathématique peut être testée par rapport à un résultat exact. Une réponse juridique, scientifique ou politique peut nécessiter une sélection de preuves, une interprétation et un jugement. Entraîner le modèle à inspecter son travail aide, mais cela ne supprime pas le besoin d'une validation indépendante. Cette limitation explique pourquoi les systèmes actuels combinent les méthodes. Les preuves d'inférence cryptographiques peuvent authentifier l'exécution. Les outils symboliques peuvent tester des affirmations formelles. Les registres de preuves peuvent contrôler ce qu'un agent est autorisé à conclure. Aucun ne couvre à lui seul l'ensemble du problème de la fiabilité. Quelle est la suite pour l'inférence prouvable ? Le prochain test est le déploiement, et non une démonstration plus vaste. Le débit et la taille des preuves rapportés par Anthropic constituent un point de départ, mais l'utilisation en production dépendra de la vitesse de vérification, des exigences de mémoire, du coût du matériel et de la manière dont les preuves se comportent lorsque des requêtes, des outils et des contextes longs sont ajoutés. Les équipes de recherche ont également besoin de comparaisons plus claires. Une preuve cryptographique doit être évaluée par rapport à un modèle de menace défini. Un vérificateur de raisonnement doit indiquer quelles affirmations il peut vérifier, quelles preuves il accepte et ce qui se passe lorsque des preuves manquent. Les gains de benchmark ne suffisent pas à démontrer qu'un système est sûr dans un environnement à enjeux élevés. Ingénierie : réduire la surcharge de génération de preuves et la taille des preuves pour les réponses longues. Évaluation : tester les modèles face à des requêtes adverses, des outils changeants et des preuves incomplètes. Gouvernance : définir ce qu'une preuve certifie et ce qui reste hors de son champ d'application. La direction émergente est celle de l'assurance multicouche. Les fournisseurs peuvent prouver quel modèle a été exécuté, les agents peuvent enregistrer quelle preuve a justifié une action et des programmes externes peuvent vérifier des affirmations formelles. Ensemble, ces mécanismes pourraient rendre les services de modèles de langage plus auditables sans exposer les poids propriétaires. La technologie passe d'une promesse abstraite à des systèmes mesurables, mais la vérification de bout en bout et de routine reste à parfaire.

Nic Reeve·