allnewscast
Breaking News
AI & Tech

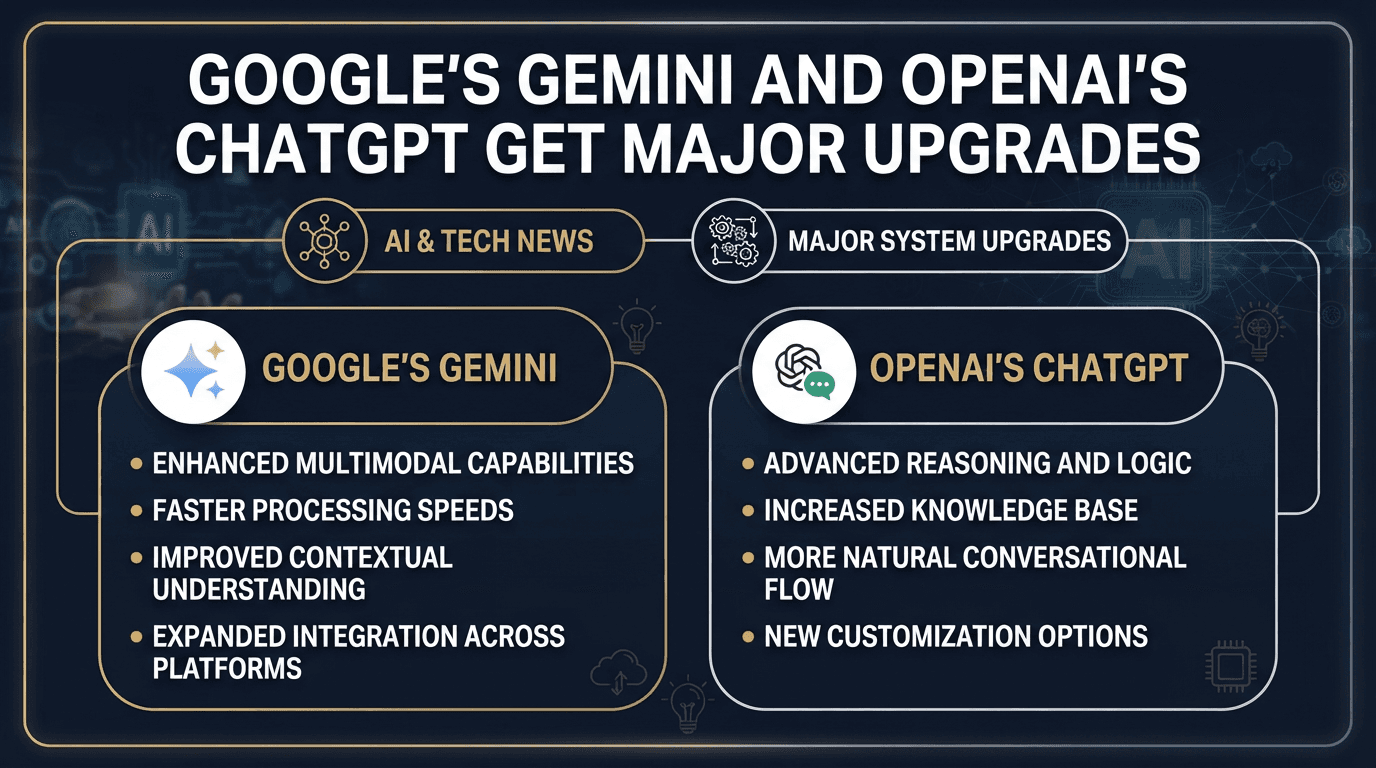
Gemini de Google et ChatGPT d'OpenAI bénéficient de mises à jour majeures en août 2026
Nic Reeve8 min de lecture
Gemini de Google et ChatGPT d'OpenAI bénéficient de mises à jour majeures en août 2026

Les plateformes d'intelligence artificielle de Google et d'OpenAI connaissent des changements rapides en août 2026, avec le lancement de nouveaux modèles, des ajustements tarifaires et des mises à jour fonctionnelles qui signalent la manière dont la prochaine génération d'assistants IA sera proposée aux consommateurs et aux entreprises.

Google accélère le déploiement de Gemini avec un nouveau modèle Flash

Google élargit sa famille de modèles Gemini en se concentrant sur des systèmes efficaces, conçus pour le codage et les flux de travail automatisés, plutôt que sur les seuls modèles phares destinés à faire la une.

Le 13 août 2026, Google a introduit Gemini 3.7 Flash, le décrivant comme son modèle d'IA le plus récent pour le support de l'ingénierie logicielle et l'automatisation d'entreprise de type « agent ». Cette sortie survient seulement trois semaines après Gemini 3.6 Flash, soulignant le rythme soutenu auquel Google fait évoluer ses modèles « Flash » de milieu de gamme.

Gemini 3.7 Flash est positionné comme un outil de travail pour les développeurs et les équipes opérationnelles. Selon la documentation développeur de Google, le modèle offre des améliorations substantielles dans le développement web, l'ingénierie logicielle et les flux de travail « agentiques », et est classé comme étant disponible au grand public via l'API Gemini.

Pour encourager l'adoption, Google propose une réduction sur l'utilisation : jusqu'à la fin de 2026, Gemini 3.7 Flash est proposé au tarif de lancement de 0,75 $ par million de jetons en entrée et 3,75 $ par million de jetons en sortie, soit environ la moitié du coût de son prédécesseur 3.6. Le modèle est déployé immédiatement sur Gemini Spark, le service d'agent IA par abonnement de Google destiné aux clients Pro et Ultra dans plus de 160 pays.

Ces changements s'appuient sur les annonces de juillet dernier concernant les modèles Gemini 3.6 Flash, 3.5 Flash‑Lite et 3.5 Flash Cyber, conçus pour équilibrer efficacité et qualité pour des flux de travail « agentiques » extensibles à travers les produits et services cloud de Google.

Gemini dépasse le milliard d'utilisateurs alors que le calendrier du modèle Pro reste flou

Parallèlement à ce nouveau modèle, Google met en avant la portée de Gemini. Début août, le PDG Sundar Pichai a déclaré que Gemini avait dépassé le cap du milliard d'utilisateurs actifs mensuels, le qualifiant de produit à la croissance la plus rapide de l'histoire de l'entreprise selon cette mesure.

L'utilisation est stimulée à la fois par les interfaces Gemini destinées au grand public et par les intégrations en entreprise. Google Cloud, par exemple, utilise désormais des outils basés sur Gemini pour faciliter la conversion de code dans son service de migration de bases de données (Database Migration Service), traduisant les procédures stockées, les déclencheurs (triggers) et les fonctions personnalisées de bases de données telles qu'Oracle et SQL Server vers le langage PL/pgSQL de PostgreSQL.

Malgré cette croissance, le statut du modèle phare de Google, Gemini Pro, reste incertain. Des rapports de l'industrie indiquent qu'une sortie anticipée de Gemini 3.5 Pro aurait été annulée en interne, alors même que les modèles de la gamme Flash deviennent largement disponibles dans les produits grand public. Google n'a pas détaillé publiquement de calendrier pour les mises à jour des modèles Pro haut de gamme, contrairement à ce qu'il a fait pour les modèles Flash.

OpenAI remanie ChatGPT avec les modèles GPT‑5.6

Simultanément, OpenAI déploie une mise à jour majeure des modèles sous-jacents et de l'expérience utilisateur de ChatGPT, en se concentrant sur des capacités de raisonnement accrues et un accès élargi pour les utilisateurs de la version gratuite.

Le 6 août 2026, OpenAI a annoncé que GPT‑5.6 Luna deviendrait le modèle par défaut pour les plans Free et Go, remplaçant les versions précédentes utilisées dans le chatbot grand public. Luna est conçu comme un assistant polyvalent pour les conversations quotidiennes et sera bientôt associé à un nouveau bouton Think (Réfléchir) qui permet aux utilisateurs de déclencher un raisonnement plus intensif sur des questions complexes, sous réserve de garde-fous de sécurité.

Dans le même temps, les abonnés Plus et Pro bénéficient d'une mise à jour du modèle GPT‑5.6 Sol. Cette version introduit un curseur permettant aux utilisateurs de choisir le niveau d'effort — et concrètement la quantité de « réflexion » computationnelle — que ChatGPT applique à une réponse, permettant ainsi d'arbitrer entre rapidité et profondeur si nécessaire. La documentation de sécurité d'OpenAI classe Luna et Sol comme ayant des capacités élevées dans les domaines de la cybersécurité, de la biologie et de la chimie, reflétant la surveillance constante des modèles avancés dans les secteurs sensibles.

Ces mises à jour remplacent GPT‑5.5 Instant dans la gamme ChatGPT et redéfinissent ce que chaque niveau d'abonnement propose. Une analyse indépendante des plans ChatGPT note que le changement d'août augmente considérablement la valeur de la version gratuite : Luna devient le seul modèle disponible pour les comptes gratuits, mais il est accompagné d'améliorations notables en matière d'utilisabilité.

Chats textuels illimités et automatisation étendue pour les utilisateurs de ChatGPT

Un changement notable dans la stratégie d'OpenAI est la décision de supprimer les limites de débit principales sur les conversations textuelles pour les utilisateurs non payants. À partir de la semaine du 10 août, les comptes Free et Go doivent bénéficier de chats textuels illimités avec GPT‑5.6 Luna, bien que des limites distinctes continuent de s'appliquer aux images, aux téléchargements de fichiers et à d'autres fonctionnalités gourmandes en ressources.

Les notes de version d'août d'OpenAI pour ChatGPT apportent des raffinements supplémentaires : le système a désormais une perception plus précise de l'heure locale de l'utilisateur, les longues conversations se chargent plus efficacement sur le web et le contenu interactif peut apparaître pendant qu'il est encore en cours de génération, améliorant ainsi la réactivité.

Côté productivité, OpenAI étend ses outils d'automatisation sous l'offre ChatGPT Work. Les mises à jour récentes incluent des tâches planifiées déclenchées par des webhooks, la gestion partagée des tâches et des limites plus flexibles pour les utilisateurs gratuits. Les capacités de navigation de ChatGPT ont également été étendues pour fonctionner sur les sites web nécessitant une connexion, avec la prise en charge des gestionnaires de mots de passe et des confirmations avant toute action conséquente, permettant aux agents IA d'effectuer des flux de travail en toute sécurité sur des services tels que Gmail, Slack et GitHub.

OpenAI retire simultanément certains modèles et fonctionnalités hérités du produit grand public ChatGPT. Les articles de support et les notes de version indiquent que le modèle o3 sera supprimé de ChatGPT à compter du 26 août 2026, et que GPT‑4.5 sera retiré suite à des dates d'arrêt annoncées précédemment. Le GPT officiel DALL·E, utilisé pour la génération d'images au sein de ChatGPT, doit être retiré le 30 août 2026, bien que ces changements n'affectent pas les offres API distinctes.

Quelle place pour LaMDA dans la stratégie actuelle de Google ?

L'ancien modèle d'IA conversationnelle de Google, LaMDA, est désormais largement éclipsé par la famille Gemini dans les annonces publiques et les supports pour développeurs. Les journaux de mise à jour récents et les blogs produits se concentrent presque exclusivement sur les modèles de la marque Gemini et les services d'agents. Bien que LaMDA ait joué un rôle central dans la première vague de grands modèles de langage de Google, l'entreprise a effectivement repositionné son discours sur l'IA autour de Gemini, en particulier dans les outils exposés aux développeurs tiers.

Les observateurs de l'industrie notent que cela représente non seulement un changement de marque, mais aussi une consolidation des feuilles de route de recherche et de produits sous une architecture unique, reflétant la manière dont OpenAI a centré ses offres sur la série GPT‑5.x. Dans la pratique, les utilisateurs interagissent avec des systèmes basés sur Gemini dans les produits Google, tandis que LaMDA subsiste principalement comme point de référence dans l'histoire de l'IA conversationnelle.

Perspectives concurrentielles : itération plus rapide, accès plus large

Dans l'ensemble, les mouvements d'août de Google et d'OpenAI mettent en évidence deux tendances étroitement liées dans l'industrie de l'IA : une itération toujours plus rapide des modèles de base et une volonté de rendre les capacités avancées accessibles à des publics plus larges.

Google mise sur le fait que des mises à jour fréquentes de modèles spécialisés comme Gemini 3.7 Flash, associées à une tarification réduite et à des services axés sur les agents tels que Gemini Spark, attireront les développeurs et les entreprises en quête d'une automatisation fiable à grande échelle. OpenAI, de son côté, utilise GPT‑5.6 Luna et Sol pour élever la qualité de base de ChatGPT, tout en supprimant les limites de chat textuel pour les utilisateurs gratuits et en renforçant ses outils d'automatisation via ChatGPT Work.

À mesure que les deux entreprises affinent leurs assistants IA, la concurrence se concentre de plus en plus non seulement sur les capacités brutes des modèles, mais aussi sur les cadres de sécurité, la tarification et la manière dont ces systèmes s'intègrent dans les outils du quotidien — des bases de données cloud aux e-mails et aux dépôts de code. Pour les utilisateurs de ChatGPT et de Gemini, l'impact immédiat ce mois-ci est une amélioration des modèles, des conditions d'utilisation plus généreuses et un ensemble croissant de fonctionnalités axées sur les tâches intégrées aux plateformes qu'ils utilisent déjà.
Lire la suite →

Articles connexes

Les chercheurs en IA s'orientent vers l'inférence vérifiable et le raisonnement auditable des modèles
AI & Tech

Les chercheurs en IA s'orientent vers l'inférence vérifiable et le raisonnement auditable des modèles

Anthropic a déclaré le 2 novembre 2026 avoir fait progresser la vérification cryptographique pour l'inférence des grands modèles de langage, présentant un système capable de générer des preuves pour un modèle de type "mixture-of-experts" (mélange d'experts) de 400 milliards de paramètres. Ce travail vise à permettre aux utilisateurs de confirmer qu'une réponse provient bien du modèle convenu et qu'elle n'a pas été altérée pendant le calcul. Anthropic a rapporté environ 110 tokens par seconde sur un seul GPU H100 pour Llama 4 Maverick dans une configuration 4-bit. L'entreprise a précisé que chaque requête de 1 024 tokens produisait une preuve d'environ 19 mégaoctets. PRIME a rapporté zéro conclusion injustifiée sur 480 tâches basées sur des registres publics, contre 26,7 % pour un agent non structuré. Qu'a démontré Anthropic ? Anthropic a décrit FlashProve, un système construit autour des arguments de connaissance succincts non interactifs à divulgation nulle de connaissance, ou zkSNARKs. Cette approche permet à un fournisseur de s'engager sur le comportement du modèle tout en gardant les détails de celui-ci cachés au vérificateur. La mise à jour de recherche d'Anthropic du 2 novembre fait suite à un changement de terminologie le 19 octobre, date à laquelle Anthropic a commencé à utiliser « vérification d'inférence » au lieu d'« inférence prouvable ». Anthropic a précisé que le test utilisait Llama 4 Maverick, un modèle MoE de 400 milliards de paramètres, plutôt qu'un petit modèle de recherche. La configuration rapportée utilisait un seul GPU H100, des poids quantifiés en 4-bit et une arithmétique entière pendant le prefill. L'entreprise a mesuré la génération de preuves à environ 110 tokens par seconde, avec des fichiers de preuve proches de 19 Mo pour 1 024 tokens générés. Ces chiffres proviennent du rapport technique d'Anthropic et non d'un benchmark indépendant. Modèle : Llama 4 Maverick, décrit par Anthropic comme un modèle MoE de 400 milliards de paramètres. Matériel : un GPU Nvidia H100. Sortie de preuve : environ 19 Mo par requête de 1 024 tokens. La question pratique est celle du coût. Une preuve doit être générée, transmise et vérifiée en même temps que la réponse. Les chiffres d'Anthropic montrent que la tâche ne se limite plus à des systèmes de démonstration, mais ils n'établissent pas que la génération de preuves est suffisamment peu coûteuse pour chaque requête de consommateur ou pour un service à haut volume. Pourquoi les preuves cryptographiques sont-elles utiles pour les modèles de langage ? La sortie ordinaire d'un modèle fournit peu de preuves sur la manière dont une réponse a été produite. Un utilisateur peut connaître le nom du fournisseur, l'étiquette du modèle et la version du logiciel, tout en manquant d'un moyen fiable de vérifier que la réponse provient bien du modèle promis. Une preuve cryptographique pourrait lier la sortie à un calcul certifié. Anthropic a déclaré que les zkSNARKs sont adaptés à cette tâche car ils peuvent fournir une vérification sans révéler les poids privés du modèle. Cette séparation est cruciale pour les systèmes commerciaux. Un fournisseur pourrait protéger son modèle tout en permettant à un client, un auditeur ou un régulateur de tester si le calcul revendiqué a bien eu lieu. La vérification ne rend pas une réponse vraie. Une preuve peut établir qu'un modèle particulier a produit un flux de tokens spécifique sous des conditions déterminées. Elle ne peut pas, à elle seule, établir que la réponse factuelle du modèle est correcte, que ses données d'entraînement étaient fiables ou que la requête était inoffensive. Ces questions nécessitent des vérifications distinctes, telles que la récupération d'informations (retrieval), des solveurs formels ou une révision humaine. Cette distinction sépare l' intégrité de l'exécution de la qualité de la réponse . Cette distinction est au cœur des dernières recherches. Le travail cryptographique vise à savoir si le calcul promis a eu lieu. D'autres systèmes visent à savoir si le raisonnement soutient la conclusion. Comment les chercheurs vérifient-ils le raisonnement lui-même ? Plusieurs études d'octobre 2026 ont abordé la vérification au niveau de la sortie et du raisonnement plutôt qu'au niveau de la couche d'exécution cryptographique. PRIME, présenté dans un article soumis le 15 octobre, impose à un agent de s'engager sur des routes de preuves avant d'évaluer des registres publics. Un programme distinct enregistre les vérifications et bloque les conclusions que ces vérifications ne justifient pas. Les auteurs de PRIME ont testé 480 tâches basées sur des registres publics. Ils ont rapporté qu'un agent conventionnel produisait une conclusion injustifiée sur 26,7 % des tâches, tandis que PRIME n'en a produit aucune. Le système a également augmenté le score moyen des conclusions justifiées, passant de 30,1 (avec le simple refus) à 59,2 après l'ajout de directives et de vérifications. PRIME : s'engage sur des règles et des routes de preuves avant de tirer des conclusions. Jeu de test : 480 tâches basées sur des registres publics. Taux d'erreur rapporté : 26,7 % pour l'agent de comparaison et zéro pour PRIME. VERGE a suivi une voie différente. L'article publié en octobre dans les EMNLP Findings décompose les réponses en affirmations atomiques, traduit ces affirmations en logique du premier ordre et les envoie à des prouveurs de théorèmes automatisés ou à d'autres contrôles. Les auteurs ont rapporté une amélioration moyenne de performance de 18,7 % lors de la convergence avec GPT-OSS-120B, par rapport aux réponses en un seul passage sur leurs benchmarks de raisonnement. Ces systèmes restreignent le champ de l'affirmation. Ils ne prouvent pas chaque partie d'une réponse ouverte. Ils vérifient des propositions sélectionnées selon des règles explicites. Quel rôle joue l'auto-vérification ? RISE, publié dans les actes de NeurIPS 2026 le 8 octobre, entraîne un modèle à résoudre des problèmes et à évaluer ses propres solutions dans le même processus d'apprentissage par renforcement. La méthode utilise des récompenses vérifiables provenant d'un vérificateur de résultats, appliquant le feedback à la fois à la génération de la solution et à l'auto-vérification. Les chercheurs ont rapporté des gains sur les benchmarks de raisonnement mathématique et un comportement d'auto-vérification plus fréquent et plus précis. La conception répond à une faiblesse connue : un modèle peut produire une critique confiante sans détecter l'erreur centrale de sa propre réponse. L'auto-vérification reste moins robuste qu'une preuve externe lorsque le vérificateur partage les angles morts du modèle. Une réponse mathématique peut être testée par rapport à un résultat exact. Une réponse juridique, scientifique ou politique peut nécessiter une sélection de preuves, une interprétation et un jugement. Entraîner le modèle à inspecter son travail aide, mais cela ne supprime pas le besoin d'une validation indépendante. Cette limitation explique pourquoi les systèmes actuels combinent les méthodes. Les preuves d'inférence cryptographiques peuvent authentifier l'exécution. Les outils symboliques peuvent tester des affirmations formelles. Les registres de preuves peuvent contrôler ce qu'un agent est autorisé à conclure. Aucun ne couvre à lui seul l'ensemble du problème de la fiabilité. Quelle est la suite pour l'inférence prouvable ? Le prochain test est le déploiement, et non une démonstration plus vaste. Le débit et la taille des preuves rapportés par Anthropic constituent un point de départ, mais l'utilisation en production dépendra de la vitesse de vérification, des exigences de mémoire, du coût du matériel et de la manière dont les preuves se comportent lorsque des requêtes, des outils et des contextes longs sont ajoutés. Les équipes de recherche ont également besoin de comparaisons plus claires. Une preuve cryptographique doit être évaluée par rapport à un modèle de menace défini. Un vérificateur de raisonnement doit indiquer quelles affirmations il peut vérifier, quelles preuves il accepte et ce qui se passe lorsque des preuves manquent. Les gains de benchmark ne suffisent pas à démontrer qu'un système est sûr dans un environnement à enjeux élevés. Ingénierie : réduire la surcharge de génération de preuves et la taille des preuves pour les réponses longues. Évaluation : tester les modèles face à des requêtes adverses, des outils changeants et des preuves incomplètes. Gouvernance : définir ce qu'une preuve certifie et ce qui reste hors de son champ d'application. La direction émergente est celle de l'assurance multicouche. Les fournisseurs peuvent prouver quel modèle a été exécuté, les agents peuvent enregistrer quelle preuve a justifié une action et des programmes externes peuvent vérifier des affirmations formelles. Ensemble, ces mécanismes pourraient rendre les services de modèles de langage plus auditables sans exposer les poids propriétaires. La technologie passe d'une promesse abstraite à des systèmes mesurables, mais la vérification de bout en bout et de routine reste à parfaire.

Nic Reeve·
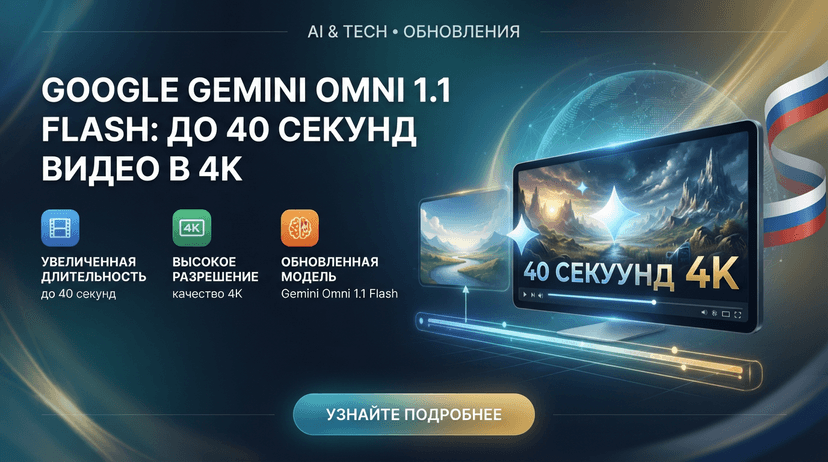
Google : Gemini 1.1 Flash étend la génération de vidéos par IA à 40 secondes en 4K
AI & Tech

Google : Gemini 1.1 Flash étend la génération de vidéos par IA à 40 secondes en 4K

Le 27 août 2026, Google a lancé Gemini Omni 1.1 Flash, un modèle vidéo IA prêt pour la production capable de générer et d'étendre des clips jusqu'à 40 secondes, avec une finition en 4K, marquant l'une des mises à niveau les plus ambitieuses de la gamme AInews en matière d'outils vidéo basés sur l'IA. Qu'a exactement lancé Google avec Gemini Omni 1.1 Flash ? Google a déployé Gemini Omni 1.1 Flash en tant que nouveau modèle de génération vidéo multimodale, axé sur le contrôle plutôt que sur la simple qualité d'image brute. Cette version ajoute l'extension de scène, les transitions basées sur des images clés, le rendu brouillon en 360p et la mise à l'échelle (upscaling) vers le 1080p et la 4K pour les développeurs utilisant l'API Gemini et les produits Google AI. Le modèle est positionné comme le moteur vidéo de production principal de Google dans la pile Gemini, remplaçant les versions antérieures limitées en termes de contexte et de résolution. Selon le blog officiel de Google, Omni prend désormais en charge une « production vidéo de qualité studio » avec des outils destinés aux monteurs et aux équipes produit, plutôt qu'à la simple expérimentation. Date de lancement : 27 août 2026, en tant que mise à jour de production de la gamme vidéo Gemini de Google. Nom du modèle : Gemini Omni 1.1 Flash, disponible via l'API Gemini et les services Google AI. Objectif principal : Un meilleur contrôle sur les scènes, les transitions et la résolution, plutôt que la seule amélioration de la qualité de génération brute. Résolutions de sortie prises en charge : 360p, 720p, 1080p et 4K via mise à l'échelle. Comment fonctionne le nouveau système d'extension de scène et pourquoi 40 secondes est-il un seuil important ? Gemini Omni 1.1 Flash introduit un système d'extension de scène avec état qui lit jusqu'à 10 secondes de séquences précédentes et étend les clips par blocs de 10 secondes, avec un plafond total de 40 secondes. Ce changement rend possibles, pour la première fois au sein du modèle, des séquences à plusieurs plans et des mouvements de caméra continus. Les systèmes vidéo précédents de Google, tels que Veo, ne prenaient en compte que la dernière seconde d'un clip avant d'en créer la suite, ce qui brisait souvent la cohérence du mouvement ou de l'éclairage. Omni 1.1 lève ce « mur de la seconde ». Il analyse un segment plus long de la vidéo existante afin que la suite puisse préserver le cadrage, le mouvement et le style. Longueur du clip de base : 3 à 10 secondes par génération, selon la documentation développeur de Google. Contexte préalable pour l'extension : Jusqu'à 10 secondes de séquences antérieures au lieu de la dernière seconde seulement. Incréments d'extension : Blocs de 10 secondes empilés au cours d'une session de montage. Longueur cumulative maximale : 40 secondes par scène lorsque les extensions sont enchaînées. Plusieurs guides de développement décrivent cela comme une « session de montage avec état » où chaque appel d'extension fait référence à un ID d'interaction précédent, ce qui signifie que le modèle suit la continuité sur plusieurs étapes plutôt que de traiter chaque requête à partir de zéro. Que signifie concrètement la finition en 4K pour les créateurs et les développeurs ? Gemini Omni 1.1 Flash ne génère pas de 4K native à partir de rien, mais utilise une mise à l'échelle pour porter les séquences générées en 1080p ou 4K. Les brouillons peuvent être produits rapidement en 360p pour réduire le temps et le coût d'itération, puis finalisés en haute résolution pour la livraison. Le blog de Google indique qu'Omni peut désormais générer des « sorties 1080p ou 4K polies et haute résolution, prêtes pour une production professionnelle », avec une 4K obtenue grâce à une passe de mise à l'échelle. Le journal des modifications de l'API Gemini confirme l'ajout d'un nouveau paramètre de résolution couvrant le 360p, le 720p, le 1080p et la 4K. Résolution du mode brouillon : 360p, décrit par Google comme étant jusqu'à 60 % plus rapide que le 720p et coûtant environ un tiers du prix. Génération standard : Clips 720p au prix et à la vitesse habituels. Finition haute résolution : Upscaling 1080p et 4K pour la livraison finale. Tarification indicative : Une analyse cite 0,03 $ par seconde en 360p, 0,10 $ en 720p, 0,15 $ en 1080p et 0,30 $ pour la 4K, selon les grilles tarifaires de l'API Gemini. Ces chiffres proviennent de sources tierces ayant analysé la documentation de Google et les listes de revendeurs, qui avertissent que les budgets de production haute résolution doivent être considérés comme provisoires jusqu'à ce que Google mette à jour sa page de tarification officielle. Quels nouveaux contrôles Omni 1.1 Flash offre-t-il sur le mouvement et le style ? La mise à jour ajoute le contrôle des images clés de début et de fin, des références vidéo courtes et des trajectoires de mouvement plus propres. Ces fonctionnalités permettent aux créateurs de définir des mouvements de caméra, de préserver le design des personnages et d'assurer une continuité stylistique sur plusieurs plans sans travail manuel de post-production. Plusieurs analyses techniques décrivent un flux de travail où l'utilisateur fournit une première et une dernière image, et le modèle génère le mouvement entre ces deux points. Cela permet des orbites, des zooms et des boucles contrôlés qui nécessitaient auparavant une animation faite à la main ou des outils externes. Transitions entre première et dernière image : Le modèle interpole le mouvement entre des images définies, améliorant le contrôle des trajectoires de caméra. Références vidéo : Jusqu'à trois secondes de séquences externes peuvent être jointes en tant que référence de style pour les personnages ou le mouvement. Qualité du mouvement : Les rapports de sites spécialisés font état de « mouvements plus propres » et de moins d'artefacts par rapport aux versions précédentes d'Omni, selon les premiers tests. Entrée multimodale : Omni Flash fonctionne avec des requêtes textuelles ainsi que des images ou de courts clips vidéo au sein de l'API Gemini. Où Gemini Omni 1.1 Flash est-il disponible et qui peut l'utiliser aujourd'hui ? Gemini Omni 1.1 Flash est disponible dans l'API Gemini et dans les produits Google AI ciblant les développeurs et les utilisateurs avancés. Il est accessible aux niveaux payants de Gemini et apparaît dans les plateformes axées sur l'entreprise utilisées pour les agents et l'automatisation des flux de travail. Selon Google et la documentation indépendante, Omni 1.1 Flash peut être appelé depuis : L'API Gemini : Exposé sous le nom gemini-omni-1.1-flash avec des options de configuration spécifiques à la vidéo. Les abonnements Google AI Plus, Pro et Ultra : Le modèle est activé dans Flow, l'environnement IA structuré de Google, et prend en charge l'extension de scène dans l'application Gemini. Les plateformes d'agents d'entreprise : Les documents cloud de Google listent Omni 1.1 Flash parmi les modèles pris en charge pour les flux de travail d'agents avec des capacités vidéo. Les revendeurs et boîtes à outils tiers : Plusieurs guides d'intégration mappent Omni Flash dans des couches de routage et des tableaux de bord développeurs. Les publications publiques de Google AI et de chercheurs indépendants sur les réseaux sociaux confirment le déploiement, citant l'extension de scène du modèle jusqu'à 40 secondes, la prise en charge du 1080p et de la 4K, ainsi qu'un mode brouillon 360p conçu pour rendre l'expérimentation moins coûteuse.

Nic Reeve·
L'ADNOC fait appel à OpenAI pour la planification de ses gisements pétroliers lors de la visite de Sam Altman à Abou Dabi
AI & Tech

L'ADNOC fait appel à OpenAI pour la planification de ses gisements pétroliers lors de la visite de Sam Altman à Abou Dabi

ADNOC, basée à Abu Dhabi, et la société d'intelligence artificielle G42 ont signé un accord avec OpenAI le 2 novembre 2026, afin de déployer l'IA avancée du créateur de ChatGPT au sein des opérations d'ADNOC. L'annonce a été faite lors de la visite aux Émirats arabes unis du PDG d'OpenAI, Sam Altman, qui a notamment inclus des discussions avec le prince héritier d'Abu Dhabi, le cheikh Khaled bin Mohamed bin Zayed Al Nahyan, ainsi qu'une apparition à l'ADIPEC. Le Bureau des médias d'Abu Dhabi a déclaré le 2 novembre qu'ADNOC était devenue la première entreprise énergétique à déployer la technologie de pointe d'OpenAI. Reuters a rapporté que le système soutiendra les décisions opérationnelles, d'investissement et commerciales à travers l'ensemble des activités d'ADNOC. Inception42 et OpenAI ont également signé un accord de cinq ans couvrant l'adoption de l'IA dans les secteurs du gouvernement, de l'entreprise et de l'éducation, a précisé le bureau des médias. Qu'ont convenu ADNOC et OpenAI ? L'accord combinera les modèles d'OpenAI avec les données industrielles d'ADNOC et ses systèmes d'intelligence artificielle existants. G42, par l'intermédiaire de sa filiale Inception42, fournira l'infrastructure informatique basée aux Émirats arabes unis. Cet arrangement est conçu pour interconnecter les décisions au sein de la compagnie énergétique, plutôt que de traiter les opérations de terrain, la planification des investissements et l'activité commerciale comme des tâches distinctes. Le PDG d'ADNOC, Sultan Al Jaber, a décrit ce partenariat comme une première pour le secteur de l'énergie. Le PDG d'OpenAI, Sam Altman, a déclaré que les modèles les plus avancés de l'entreprise seraient utilisés pour résoudre des problèmes complexes et à haute valeur ajoutée auxquels ADNOC est confrontée, notamment les demandes énergétiques générées par l'expansion de l'IA. Le Bureau des médias d'Abu Dhabi a précisé que le déploiement s'appuiera sur les modèles GPT d'OpenAI en utilisant une infrastructure d'inférence locale. Selon les informations de Forbes Middle East et Arabian Business, des spécialistes humains resteront responsables des décisions cruciales. Quelles activités d'ADNOC utiliseront la technologie en premier ? Les premières applications se concentreront sur le développement des champs pétroliers et l'évaluation du brut avant sa production. Les outils d'IA examineront les données historiques des puits et des réservoirs d'ADNOC, parallèlement aux coûts de production, aux conditions du marché et aux rendements attendus. L'objectif affiché est de raccourcir les cycles de planification et d'offrir aux gestionnaires une vision plus intégrée de la chaîne énergétique. Arabian Business a rapporté que la première application analysera les données de milliers de puits, de multiples réservoirs et de centaines d'installations. Le même rapport indique que le système pourrait réduire certains travaux de planification du développement, les faisant passer de plusieurs mois à quelques heures. ADNOC prévoit d'évaluer la valeur potentielle de chaque baril avant l'extraction en examinant l'offre, la demande, les prix et les marges. Cette seconde utilisation dépassera le cadre du forage. L'analyse pourrait éclairer les décisions de production, de raffinage, de transport et de commerce. ADNOC utilise déjà sa plateforme ENERGYai pour générer de l'intelligence sur les réservoirs, les actifs et les opérations. OpenAI Frontier est destiné à connecter ces capacités à l'échelle de l'entreprise. Pourquoi G42 est-elle cruciale pour ce partenariat ? G42 fournit l'infrastructure locale qui hébergera le déploiement aux Émirats arabes unis. Maintenir l'inférence à l'intérieur du pays répond aux exigences de résidence et de contrôle des données, tout en donnant à ADNOC l'accès à des modèles avancés via un partenaire technologique émirati. Le partenariat s'étend également au-delà du pétrole et du gaz. Le Bureau des médias d'Abu Dhabi a indiqué qu'Inception42 et OpenAI ont signé un accord distinct de cinq ans pour soutenir l'adoption de l'IA de pointe dans les secteurs public, privé et éducatif. Cet arrangement place G42 au centre d'un effort plus large visant à renforcer les capacités nationales autour des systèmes OpenAI. Le rôle de G42 reflète également la volonté plus large d'Abu Dhabi de lier l'infrastructure informatique aux industries stratégiques. Les entreprises n'ont pas divulgué la valeur financière de l'accord avec ADNOC, le nombre de systèmes à déployer, ni de calendrier précis de mise en œuvre. Que s'est-il passé lors de la visite de Sam Altman aux Émirats arabes unis ? Selon le Bureau des médias d'Abu Dhabi, Altman a rencontré le cheikh Khaled à Abu Dhabi le 2 novembre. La réunion a porté sur l'élargissement de la coopération en matière d'intelligence artificielle et a précédé les cérémonies de signature liées à ADNOC, G42 et OpenAI. Altman a également assisté à l'ADIPEC, la principale conférence sur le pétrole et le gaz des Émirats arabes unis, où le partenariat énergétique a été annoncé. Reuters a décrit cette visite comme faisant partie du renforcement des liens d'OpenAI avec les Émirats arabes unis, tandis que l'Economic Times a rapporté que l'accord avec ADNOC a été signé lors de la conférence. L'énergie est au cœur de cette relation. Les systèmes d'IA nécessitent d'importantes quantités d'électricité et de capacité de calcul, tandis que les entreprises énergétiques détiennent des ensembles de données industrielles complexes qui peuvent alimenter des modèles spécialisés. L'accord avec ADNOC réunit ces deux intérêts dans un cadre commercial. Quelles autres mesures de protection et applications sont incluses ? L'accord comprend des travaux de cybersécurité via le programme Daybreak Blue d'OpenAI, selon The Next Web et Arabian Business. Cette initiative vise à aider ADNOC à identifier les risques numériques et à protéger les infrastructures énergétiques à mesure que les systèmes opérationnels se connectent. Les employés d'ADNOC recevront également une formation liée au déploiement, a rapporté The Next Web. Cette formation devrait favoriser l'utilisation d'agents d'IA dans les différentes fonctions de l'entreprise, tout en préservant la supervision d'experts pour les décisions à fort impact. Les modèles d'OpenAI seront combinés aux données industrielles propriétaires d'ADNOC. G42 fournira l'infrastructure informatique située aux Émirats arabes unis. Des experts humains superviseront les choix opérationnels et commerciaux cruciaux. La cybersécurité et la formation de la main-d'œuvre font partie du déploiement global. Les entreprises n'ont pas publié d'estimations indépendantes concernant les économies de coûts attendues, les gains de productivité ou les effets sur les émissions. Ces mesures détermineront si le partenariat dépassera le stade du lancement médiatisé pour devenir un usage courant au sein du vaste réseau opérationnel d'ADNOC. Quelle est la suite pour le partenariat ADNOC ? ADNOC, G42 et OpenAI devraient développer la plateforme personnalisée d'intelligence décisionnelle avant d'étendre son utilisation à l'ensemble de la compagnie énergétique. Les premiers travaux se concentreront sur la planification du développement des champs et l'évaluation des barils avant production, les applications ultérieures pouvant atteindre d'autres fonctions opérationnelles et commerciales. L'accord de cinq ans avec Inception42 prévoit un calendrier distinct pour l'adoption dans les institutions publiques, les entreprises et les écoles. Son envergure rend l'annonce du 2 novembre plus vaste qu'un simple contrat technologique pétrolier et gazier, bien que les parties n'aient pas communiqué d'étapes clés pour l'un ou l'autre accord. Le prochain test sera pratique : l'IA pourra-t-elle transformer les données d'ADNOC en une planification plus rapide, des installations plus sûres et des décisions de marché mieux informées, tout en maintenant la responsabilité entre les mains du personnel humain ? L'infrastructure basée aux Émirats arabes unis donnera également à Abu Dhabi un rôle direct dans l'exploitation des systèmes qui soutiennent ces décisions.

Nic Reeve·